How to Install Spark Cluster


 Hi All 今天要介紹的是如何建置一套Spark Cluster分散式平台,Spark是一套機器學習靈活的計算分散式框架平台,適合做批次處理、資料流資理,Spark SQL,機器學習等不同的應用。因些Spark可應用在廣泛的大數據計算引擎。

● Spark 平台框架圖


1.下載Spark 
首先到Spark官方網站下載 Spark 1.6.0 ,選擇需要下載的版本及對應Hadoop版本。
**注意**Spark 官方所提供的Scala 版本為2.10,如果你想要製作在Scala 2.11需要重新Builder Source Code才可以。 
Download Page  http://spark.apache.org/downloads.html 

使用Wget 下載檔案,將檔案解壓縮
1
2
user@Master:~$ wget http://ftp.mirror.tw/pub/apache/spark/spark-1.6.0/spark-1.6.0-bin-hadoop2.6.tgz
user@Master:~$ tar -xzvf spark-1.6.0-bin-hadoop2.6.tgz


2. Configurations 設定 
我們將使用三台虛擬器,建置Spark Cluster分散式平台
  • 新增spark-env.sh
複製 con/spark-env.sh.template 新增一個 spark-env.sh檔案
    1
    user@Master:~$ cp con/spark-env.sh.template spark-env.sh
    

    • 編輯Spark-env.sh檔案
    1
    user@Master:~$ vi ~/spark/conf/spark-env.sh
    

    • 設定Hadoop路徑
    1
    HADOOP_CONF_DIR=~/hadoop/etc/hadoop/
    

    • 設定Spark JDBC Dirver,如果需要使用到mssql或是mysql將jar加入即可
    1
    SPARK_CLASSPATH=~/spark/extraClass/sqljdbc41.jar
    

      • 新增Spark slaves 
      複製 conf/slaves.template,改成 conf/slaves檔案
      1
      user@Master:~$ cp slaves.template slaves
      

      • 編輯Configure Slaves.
      編輯slaves檔案加入我們三台虛擬機器,我們直接使用hostname,需先設定/etc/hosts檔案,將三台虛擬器機名稱加入。
      ** 注意**如果沒有加入hostaname,直接加入hostname在Spark slave,Spark Cluster將無法找到Master與slave設備 
      1
      user@Master:~$ sudo vi /etc/hosts 
      

      1
      2
      3
      192.168.2.100 master
      192.168.2.101 slave1
      192.168.2.102 salve2 


      1
      user@Master:~$ vi ~/spark/conf/slaves
      

      1
      2
      3
      master
      slave1
      slave2


      • 編輯spark-defaults.conf,指定Spark other Port,如不需要請跳過此步至下一步 
      複製conf/spark-defaults.conf.template,改成conf/spark-defaults.conf 檔案
      1
      user@Master:~$ cp sparkdefaults.conf.template spark-defaults.conf
      

      1
      user@Master:~$ vi ~/spark/conf/spark-defaults.conf
      

      1
      2
      3
      4
      5
      6
      spark.driver.port   51810
      spark.fileserver.port   51811
      spark.broadcast.port   51812
      spark.replClassServer.port  51813
      spark.blockManager.port   51814
      spark.executor.port   51815


      3. 啟動 Spark Cluster
       啟動Spark Cluster有兩種方法:
      1.啟動start-all.sh,至動作自動將會啟動master及slave Cluster Server
      2.啟動start-master.sh及start-slave.sh
      1
      user@Master:~$ spark/sbin/start-all.sh
      

      透過jps查看所以Spark Cluster是否啟動成功 
      1
      user@Master:~$ jps
      

      1
      2
      3
      4
      15398 ResourceManager
      18483 NameNode
      1633 Master
      1733 Jps
      

      1
      user@slave1:~$ jps
      

      1
      2
      3
      4
      14398 Worker
      1283 NodeManager
      1433 DataNode
      1633 Jps


      How to Install Elasticsearch Cluster


      Elasticsearch Cluster建置


      Elasticsearch 底層為Apache Lucene 開源搜尋引擎,以分散式平台,十分高效能。
      主要優點:
          分散式儲存。
          簡單新增Cluster
          搜尋速度快
      設備:
          ubuntu server 14.04
         Java 8
         Elasticsearch 2.1.1

      1. 安裝Elasticsearch之前需要安裝JAVA
      首先使用apt-get新增JAVA Repository
      sudo add-apt-repository ppa:webupd8team/java
      sudo apt-get update
      sudo apt-get install oracle-java8-installer
      測試是否安裝成功 java -version
      設定JAVA_HOME
      sudo vi /etc/bash.bashrc
      #加入JAVA_HOME
      export JAVA_HOME=/usr/lib/jvm/java-8-oracle
      export PATH=$JAVA_HOME/bin:$PATH


      2.安裝Elasticsearch Cluster三台集群 使用ubuntu 14.04版本
      Elasticsearch官方下載檔案,使用的檔案為deb,後面階段要讓Elasticsearch開機時自動啟動所以選擇deb,可以選擇其他檔案格式。
      wget https://download.elastic.co/elasticsearch/elasticsearch/elasticsearch-2.1.1.deb 
      下載完畢後使用dpkg安裝deb
      sudo dpkg -i elasticsearch-2.1.1.deb
      安裝完成將 Elasticsearch設定自動啟動功能,重新開機測試是否正常
      sudo update-rc.d elasticsearch defaults
      查看是否有啟動成功
      curl -X GET 'http://localhost:9200'
      
      Elasticsearch Server將會回傳json格式
      {
        "name" : "test",
        "cluster_name" : "Neil",
        "version" : {
          "number" : "2.1.1",
          "build_hash" : "8ff36d139e16f8720f2947ef62c8167a888992fe",
          "build_timestamp" : "2015-01-27T13:32:39Z",
          "build_snapshot" : false,
          "lucene_version" : "5.4.1"
        },
        "tagline" : "You Know, for Search"
      }

      手動啟動
      sudo service elasticsearch start
      3.設定yml檔
      設定elasticsearch.yml檔案路徑,權限問題無法使用ls查看,直接修改即可
      sudo vi /etc/elasticsearch/elasticsearch.yml
      Master Server設定
      cluster.name: neil
      node.name: ${HOSTNAME}
      
      node.master: true node.data: false
      #指定10.1.0.5為Master Server
      discovery.zen.ping.unicast.hosts: ["10.1.0.5"]
      discovery.zen.ping.multicast.enabled: false
      discovery.zen.minimum_master_nodes: 1 
      
      Slave node-1 設定
      cluster.name: neil
      node.name: ${HOSTNAME}
      node.master: false
      node.data: true
      #指定10.1.0.5為Master Server
      discovery.zen.ping.unicast.hosts: ["10.1.0.5"]
      discovery.zen.ping.multicast.enabled: false
      discovery.zen.minimum_master_nodes: 1 


      Slave node-2 設定
      cluster.name: neil
      node.name: ${HOSTNAME}
      node.master: false
      node.data: true
      #指定10.1.0.5為Master Server
      discovery.zen.ping.unicast.hosts: ["10.1.0.5"]
      discovery.zen.ping.multicast.enabled: false
      discovery.zen.minimum_master_nodes: 1 

      Elasticsearch現在已經更新到5.x多版本了,設定大同小異沒有什麼變動,如果你需要用以上的設定安裝5.x 版本一樣也是可以使用的,差別在於plugin安裝,如果安裝elasticsearch-head不能跟舊版本一樣使用 plugin install elasticsearch-ehad會出問題 , 需要安裝grunt來當 Server,啟動Elasticsearch-head即可。

      資料來源:
       https://www.elastic.co/guide/en/elasticsearch/reference/current/index.html

      Test Hadoop mapreduce 效能


      Hadoop MapReduce 效能測試

      Hadoop是廣泛被使用運算平台,其中MapReduce提供平行運算的功能。而MapReduce 的架構可區分為 Map 與 Reduce 兩階段,在Hadoop JAR裡面有提供測試MapReduce的效能,接下來測試我們的Hadoop的效能,使用Hadoop Examples提供Teragen與Terasort的功能。
       
      1.首先我們在Hadoop hdfs建立root帳號,將資料夾修改為root可以讀取修改的權限。
                hadoop fs -mkdir /user/root
                hadoop fs -chown root /user/root

      2.建立Teragen 1250000000MB 測試資料,將資料儲存在root/teragen資料夾。
                yarn jar /usr/hdp/current/hadoop-mapreduce-client/hadoop-mapreduce-examples.jar teragen -Dmapred.map.tasks=120 1250000000 /user/root/teragen
              
      3.建立完成Teragen資料,使用Terasort計算1250000000MB 資料花費時間,將資料儲存在root/terasort資料夾。
                time yarn jar /usr/hdp/current/hadoop-mapreduce-client/hadoop-mapreduce-examples.jar terasort -Dmapred.reduce.tasks=32 /user/root/teragen /user/root/terasort

      4.執行完畢後,將顯示以下畫面,Terasort花費時間為40分鐘。

      real    40m15.438s
      user    0m21.817s
      sys     0m2.856s

      可以測試自已部內Hadoop效能。

      刪除建立Terasort資料
                 hadoop fs -rm -r /user/root/terasort

      How to Install Hortonworks HDInsight Cluster Amabari教學


      Install Hortonworks HDInsight 2.3.2


              話說BIG DATA已經是非常熱門,你想像到所以東西都可以於BIG DATA有關,但是要如何架設一套良好BIG DATA分析系統,這是一件非常困難,而國外已經有當相多公司在使用BIG DATA技術,有很多已經幫我們整理好Open Source 資料。
              在台灣只有一些大公司投入BIG DATA技術,而瞭解Hadoop相關技術是有難度,如何利用Hadoop技術解決問題並分析資料是一個關鍵。
             接下來我們教你如何自行架設一套Open Source 軟體Hortonworks HDInsight。
      以我們設備有五台電腦主機分別為兩台為Master,三台為DataNode ,架設Hadoop Cluster。
      看個人需求,我們以Centos 6.7 Linux版本。

      首先安裝Mysql DB因為Ambari需要將資料存入Mysql DB,也可以自行選擇安裝其他資料庫。

      例如:
      •  PostgreSQL (Embedded)
      •  Oracle
      •  MySQL
      •  PostgreSQL
      •  Microsoft SQL Server (Tech Preview)
      •  SQL Anywhere
      為什麼要選擇Mysql,因為我對Mysql比較熟,所以選擇我最熟悉資料庫。

      1.安裝Mysql Server
      選擇一台高階電腦主機當Ambari Server Master
      yum install -y mysql-server mysql
      在來關閉防火牆centos,或是可以使用 ntsysv來關閉
      chkconfig iptables
      /etc/init.d/iptables stop
      

      開起所有設備NTP ,將所有主機設備對時。
                chkconfig --list
                ntpdchkconfig ntpd on
                service ntpd start

      2.設定Mysql 授權
      先檢查看Mysql是否有啟動, 如果未啟動Mysql請將Mysql server啟動。
                ps aux | grep mysql
      開起Terminal 輸入Mysql root指令新增root密碼 ,預設值是沒有密碼。
                mysqladmin -u root password '你的密碼'

      登入mysql確認設定root密碼是否正常
                mysql -uroot -p

      3.新增Mysql Ambari帳號授權
      注意密碼在後面安裝ambari需要用到。
      [localhost]create user 'ambari'@'localhost' identified by '輸入密碼';grant all PRIVILEGES on *.* to 'ambari'@'localhost'; 
      [%]create user 'ambari'@'%' identified by '輸入密嗎';grant all PRIVILEGES on *.* to 'ambari'@'%'; 
      [host名稱] 注意如果不需要請下一步。
      create user 'ambari'@'host名稱' identified by '輸入的密碼';
      grant all PRIVILEGES on *.* to 'ambari'@'host名稱';
      • 透過root帳號使用MysqlWorkbench工具連接MysqlDB
      grant all privileges on *.* to 'root'@'%.%.%.%' identified by '' with grant option;flush privileges;exit


      下載 MysqlWorkbench 工具

      4.設定主機/etc/hosts

      設定所有主機設備 /etc/hosts, 假設有三台hadoop設備 範例:
      • 10.0.1.4 hdp01
      • 10.0.1.5 hdp02
      • 10.0.1.6 hdp03
      5.安裝Hortonworks Ambari Server

      一、安裝Abmari repo
      首先下載repo檔案至/etc/yum.repo.d路徑 ,其他Linux請連接官方Hortonworks網站 repo
                Ambari Server repo檔
                wget -nv http://public-repo-1.hortonworks.com/ambari/centos6/2.x/updates/2.1.2/ambari.repo -O /etc/yum.repos.d/ambari.repo
                HDP 2.3.2 repo檔
                wget -nv http://public-repo-1.hortonworks.com/HDP/centos6/2.x/updates/2.3.2.0/hdp.repo -O /etc/yum.repos.d/hdp.repo

      如果需要透過local repo連接Abmar Server請安裝repolist, createrepo,httpd,不需要請下一步。
                yum repolist   `使用repo需要的套件`


                yum install -y createrepo  `使用createreop需要的套件`
                yum install -y httpd

      開始安裝Ambari Server
                yum install -y ambari-server

      注意:在安裝Abmari Server先前請安裝好java JDK,Abmari Server可自行指定java版本,如果不指定Abmari Server 安裝時請選擇open source java JDK
      自行指定[修改java版本]教學

      二、設定Ambari Server JDBC
                指定Ambari連接mysql jdbc套件。這個很重要、很重要、非常很重要,如果沒設定Ambari將無法接連到mysql資料庫。(這問題我卡了一兩天 =.=")

                yum install -y mysql-connector-java*
                ls /usr/share/java/mysql-connector-java.jar    `請將jar檔的權限為644`


                ambari-server setup --jdbc-db=mysql --jdbc-driver=/usr/share/java/mysql-connector-java.jar

      三、開始安裝Abmari Server
                ambari-server setup

      執行前請先檢查mysql是否已設定完成
      • WARNING: SELinux is set to 'permissive' mode and temporarily disabled. OK to continue [y/n] (n)?
      請輸入 Y
      • Customize user account for ambari-server daemon [y/n] (n)? y
      請輸入: Y
      • iptables is running. Confirm the necessary Ambari ports are accessible. Refer to the Ambari documentation for more details on ports. OK to continue [y/n] (y)?
      請輸入: Y

      請選擇需要安裝的java版本或是可以直接自行安裝JAVA版本
      • [1] Oracle JDK 1.8 + Java Cryptography Extension (JCE) Policy Files 8
      • [2] Oracle JDK 1.7 + Java Cryptography Extension (JCE) Policy Files 7
      • [3] Custom JDK
      • Enter advanced database configuration [y/n] (n)?
      請輸入: Y 

      選擇安裝Ambari Server儲存的資料庫,前面我們選擇Mysql所以我們是選擇3
      Choose one of the following options:
      • [1] - PostgreSQL (Embedded)
      • [2] - Oracle
      • [3] - MySQL
      • [4] - PostgreSQL
      • [5] - Microsoft SQL Server (Tech Preview)
      • [6] - SQL Anywhere
      接下來設定Ambari資料庫連接
      • Hostname (localhost): localhost  
      • Port (3306): 3306  
      • Database name (ambari): ambari資料庫名稱
      • Username (ambari): ambari登入名稱
      • Enter Database Password (bigdata): ambari資料庫密碼
      • Proceed with configuring remote database connection properties [y/n] (y)? y
      請輸入: Y

      最後顯示以下訊息你將安裝成功ambari-server
      * Ambari Server 'setup' completed successfully.

      使用MysqlWorkbench工具連接檢查是否有新增ambari資料庫。

      **手動新增ambari 資料庫及資料表
                mysql -u ambari -p 你的ambari密碼 
                create database ambari;
                SHOW DATABASES;
                use ambari
                SOURCE /var/lib/ambari-server/resources/Ambari-DDL-MySQL-CREATE.sql;
                flush privileges;
                exit

      注意 Ambari-DDL-MySQL-CREATE.sql檔案放在 /var/lib/ambari-server/resources/

      四、其他台設備安裝 Ambari-agent
      首先將Ambari-server上的ambari.repo及hdp.rep,hdp-util.repo檔案複製到其他台設備。

      *注意:使用loca reop 需要安裝httpd,其他台機器才可以連接到Abmari Server資料
      的repo檔案

      複製ambari,hdp,hdp-utils檔案至其他設備
                scp /etc/yum.repos.d/hdp.repo 帳號@ip:/etc/yum.repos.d/ambari.repo
                scp /etc/yum.repos.d/hdp.repo 帳號@ip:/etc/yum.repos.d/hdp.repo
                scp /etc/yum.repos.d/hdp.repo 帳號@ip:/etc/yum.repos.d/hdp-utils.repo          

      其他設備安裝ambari-agent
                yum install -y ambari-agent

      設定Server讓agent連接server
                vi /etc/ambari-agent/conf/ambari-agent.ini 

                [server]
                hostname=hdp01   `你的Abmari Server`
                url_port=8440


                secured_url_port=8441

      五、建立Linux免密碼登入

      在每一台hadoop設備輸入ssh-keygen建立key,將所有建立完成的key集中在Server ~/.ssh/authorized_keys 檔案內,使用scp將authorized_keys檔案複製到每一台hdp設備 ~/.ssh路徑
               
                ssh-keygen
                cat id_rsa.pub >> authorized_keys
                scp ~/.ssh/authorized_keys  root@:~/.ssh/authorized_keys


      6.設定local repo連接
      一、建立Ambari local
      透過Ambari Server設備使用repo下載點,不需要每一天設備從網路上下載。
      如果不設定repo每台機器是直接從網路下載資料,這將會浪費相當多的時間在下載資料,設定完成後,所有Client設備將會從Server端下載repo資料,減少下載時間。

      首先在Server端安裝httpd,資料夾放的路徑為 /var/www/html。
                yum install -y httpd
                #建立資料夾
                mkdir -p /var/www/html/ambari
                cd /var/www/html/ambari

      下載Ambari資料至var/www/html/abmari資料夾,並建立repo下載點。
                reposync -r Updates-ambari-2.1.2  
                createrepo /var/www/html/ambari/Updates-ambari-2.1.2

      二、修改Abmari repo檔案

      下載完畢,首先修改Ambari.repo檔案,路徑為 /etc/yum.repos.d/,將repo url修改為Ambari Server IP即可。
                vi /etc/yum.repos.d/ambari.repo 

                #VERSION_NUMBER=2.1.2-377
                [Updates-ambari-2.1.2]
                name=ambari-2.1.2 - Updates
                baseurl=http:///ambari/updates/2.1.2
                gpgcheck=0
                enabled=1
                priority=1

      注意:Server需先安裝httpd,檔案放至路徑為/var/www/html/

      三、建立HEP Local
      建立hdp資料夾
                mkdir -p /var/www/html/hdp

      下載hdp repo local資料至var/www/html/hdp Server端
                cd /var/www/html/hdp
                reposync -r HDP-2.3.2.0

                createrepo /var/www/html/hdp/HDP-2.3.2.0

      四、修改hdp repo檔案
      全部下載完畢後,修改hdp.repo檔案把url改成Ambari server ip位址,hdp.repo檔案包含hdp、hdp-utils資料,將原本的url修改成Ambari Server IP與gpgcheck修改為0。
                
                vi /etc/yum.repos.d/hdp.repo

                #VERSION_NUMBER=2.3.2.0-2950

                [HDP-2.3.2.0]
                name=HDP Version - HDP-2.3.2.0  
                baseurl=http://hdp/HDP-2.3.2.0
                gpgcheck=0
                enabled=1
                priority=1

                [HDP-UTILS-1.1.0.20]
                name=HDP Utils Version - HDP-UTILS-1.1.0.20
                baseurl=http://hdp/HDP-UTILS-1.1.0.20
                gpgcheck=0
                enabled=1
                priority=1

      五、複製repo至其他設備

      修改完成repo檔案後,將ambari.repo與hdp.repo檔案copy至每一台hadoop設備路徑 /etc/yum.repos.d/ 資料夾裡面即可
                scp /etc/yum.repos.d/hdp.repo 帳號@ip:/etc/yum.repos.d/ambari.repo
                scp /etc/yum.repos.d/hdp.repo 帳號@ip:/etc/yum.repos.d/hdp.repo
                scp /etc/yum.repos.d/hdp.repo 帳號@ip:/etc/yum.repos.d/hdp-utils.repo      


      7.安裝Ambari-Agent
      將以上功能設定完畢後,開始安裝設備Agent,在每一天機器上安裝Ambari-agent,

                yum install -y ambari-agent

      注意:Server端也需要安裝,不然無法回傳資料給Server。


      8.開始安裝HDInsight Cluster
      首先將Server端Amabari起動,在將其他機器Agent起動即可。
                ambari-server start
                amabari-agent st

      一、開起瀏覽器輸入網址http://localhlst:8080,ambari預設port為8080,輸入你設定帳號密碼。


      二、點選右上角launch install wizard


      三、輸入ambari hdp名稱。

      四、設定Server端Provide SSH Private key,讓Server可以直接連接Client不需要登入帳號密碼。


      五、設定repo連接點,如果有使用repo loca,直接使用Server IP,如果沒有設定直接連接Hortonworks官方網站repo。

      六、安裝設備名稱,點選OK


      七、檢查設備是否缺少套件,這需要一點時間,檢查完畢後將會顯示以下畫面 
       注意:在按下一步先前請點選Click here to see the check results, 檢查所有設備是否符合及其他設定。出現錯誤訊息請解決,否則在安裝時將會無法完成。


      八、選擇需要安裝HDInsight套件

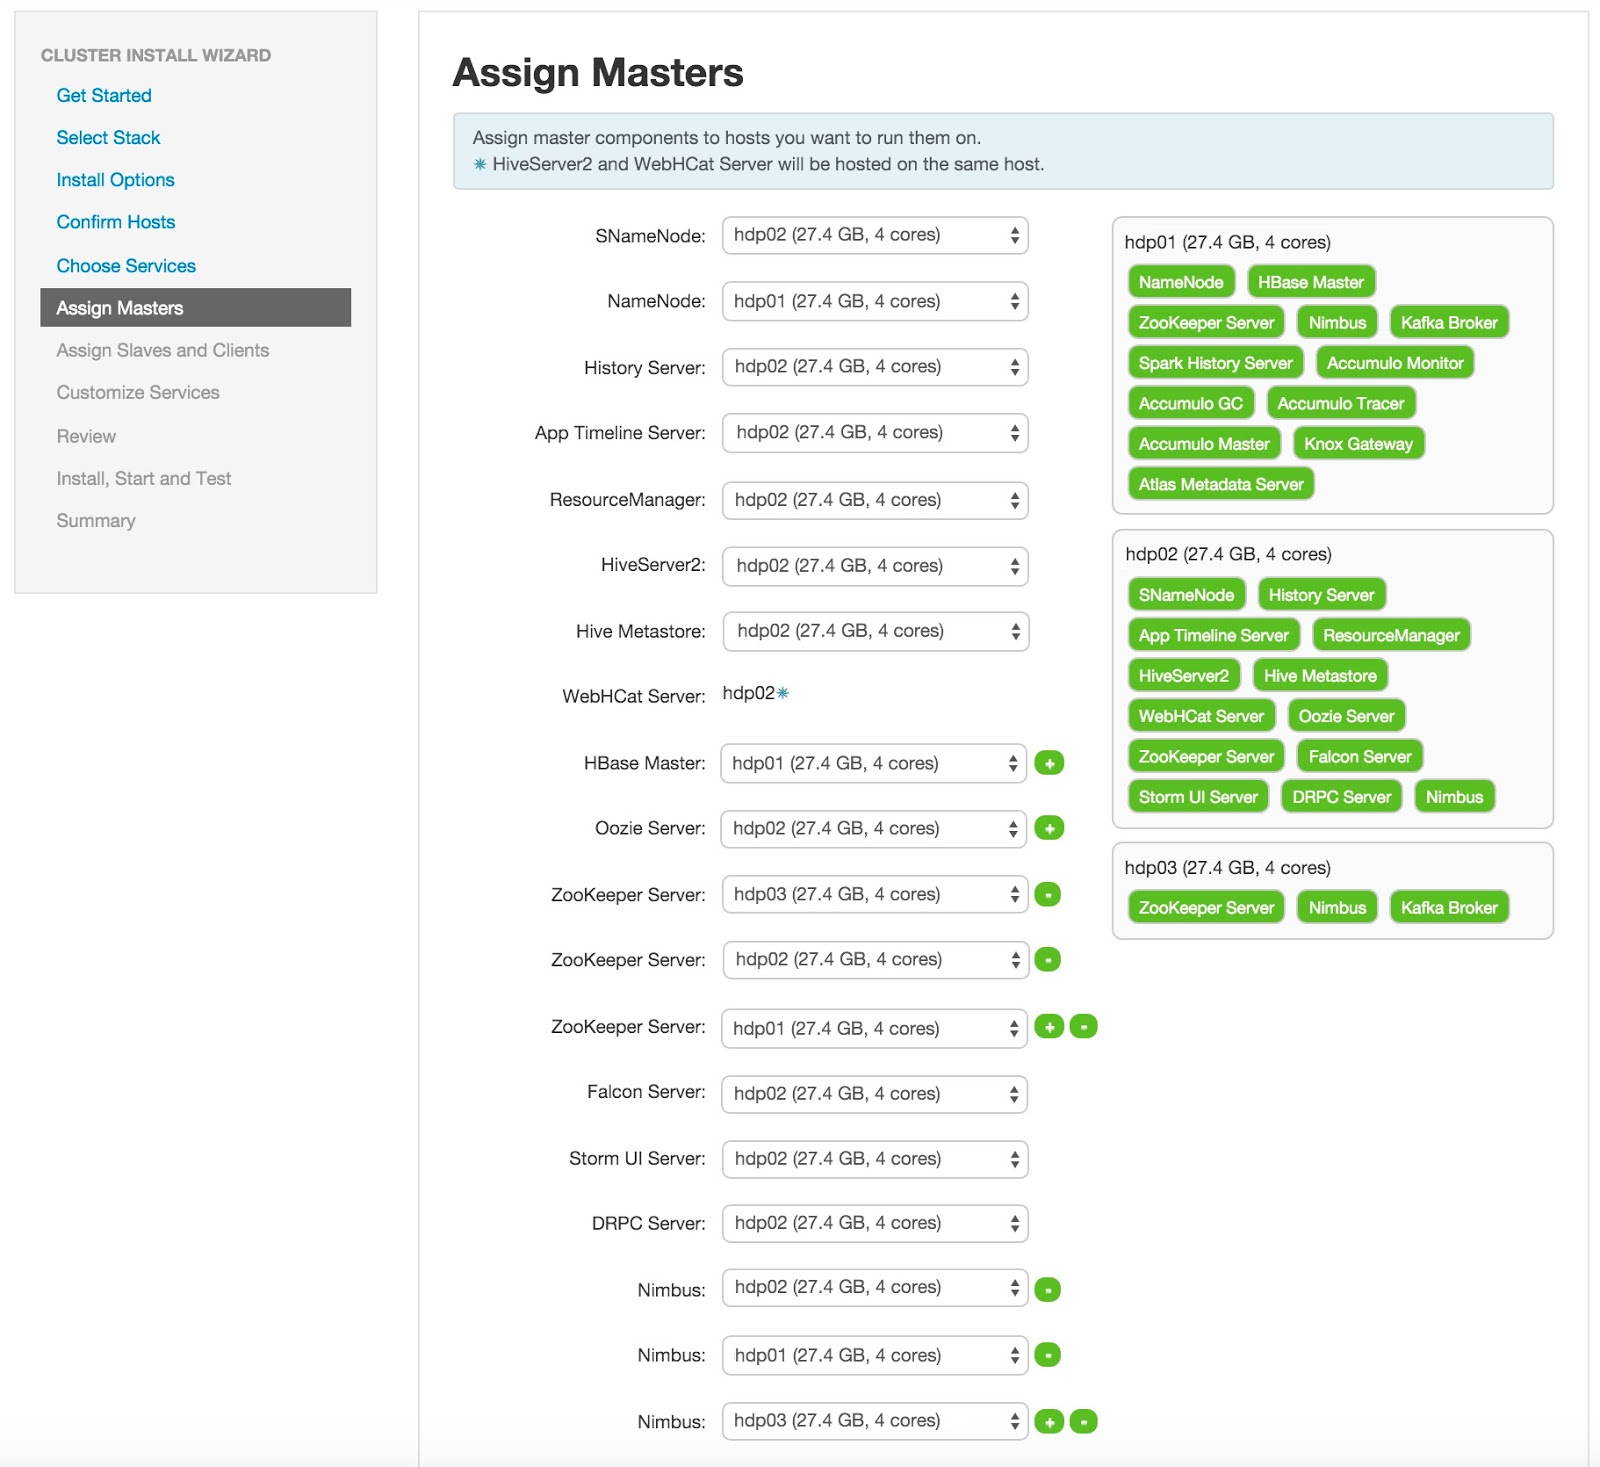
      九、選擇將軟體安裝在那一台機器設備,將有關Master軟體安裝在前兩~三台。

      十、選擇Slaves與Clients

      十一、設定Hive、Ooiz、Accumlo、Knox帳號密碼。

      十二、設定完成,下一步

      十三、顯示Review 設定參數,下一步 


      十四、Preparing to Deploy中....


      十五、開始安裝HDInsight Cluster
       十六、安裝完成,開起你的瀏覽器輸入http://localhost:8080,登入帳號密碼,起動所有設備即可。


       問題解決:
      在檢查過程當中遇到"The following hosts have Transparent HugePages (THP) enabled。THP should be disabled to avoid potential Hadoop performance issues."錯誤訊息。

      解決方法,在Linux下執行:
                echo never >/sys/kernel/mm/redhat_transparent_hugepage/defrag
                echo never >/sys/kernel/mm/redhat_transparent_hugepage/enabled
                echo never >/sys/kernel/mm/transparent_hugepage/enabled
                echo never >/sys/kernel/mm/transparent_hugepage/defrag


      References: